英伟达破局 AI 内存瓶颈:HBM 仅增约 3%,每美元智能体吞吐量最高提升 30 倍
2026.11.06 · 收录日 2026.11.06 · 观点 · 行业动态 · 媒体报道
英伟达提出全栈协同设计,用低精度压缩与分层存储缓解 HBM 压力。
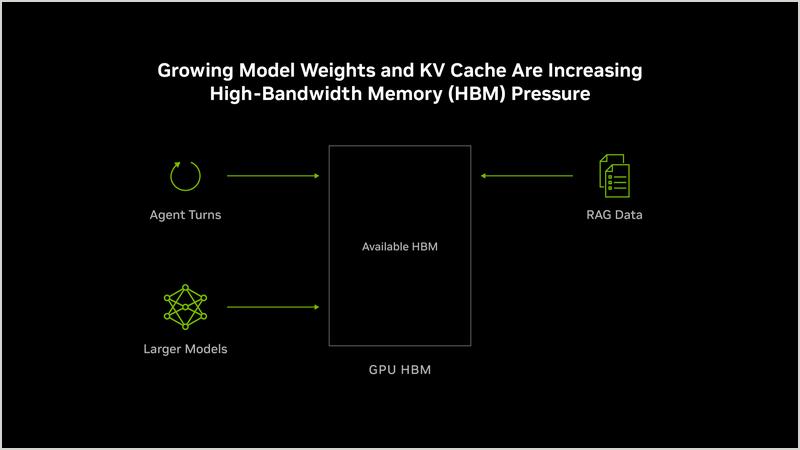
英伟达发布技术解读,指出大模型参数、上下文与智能体应用增长让 GPU 显存承压、HBM 供应趋紧。为此其引入全栈协同设计,通过 NVFP4 压缩、NVL72 分散权重、Vera CPU 缓冲与 Dynamo 迁移上下文等方案提升内存价值。援引 SemiAnalysis AgentX 基准,Vera Rubin NVL72 每美元智能体吞吐量较 GB300 NVL72 最高提升 30 倍,而每 GPU 的 HBM 容量仅增约 3%。
- 英伟达指出大模型参数、上下文长度和智能体应用增长,使 GPU 显存承压、HBM 供应趋紧且价格上升。
- 方案核心是全栈协同设计,把 GPU、CPU、网络、存储和软件作为整体,让每字节内存在各层级产生更高价值。
- NVFP4 低精度格式可压缩模型权重和 KV 缓存,NVL72 中模型权重可分散至最多 72 颗 GPU。
- Vera CPU 的大容量 LPDDR 内存为暂停上下文提供缓冲,Dynamo 推理软件将不活跃上下文迁移至 CMX 上下文存储。
- SemiAnalysis AgentX 基准显示,Vera Rubin NVL72 每美元智能体吞吐量较 GB300 NVL72 最高提升 30 倍,HBM 容量仅增约 3%。
为什么值得看
看清 AI 算力竞争从拼显存转向拼每字节、每瓦特的有效 token 产出。
适合谁关注
关注 AI 算力、GPU 架构与推理成本的技术和投资读者。