百万小时数据喂下去,机器人就能学会一切?这场塔尖会拆解「具身数据战」
2026.11.06 · 收录日 2026.11.06 · 事件 · 行业动态 · 媒体报道
张江塔尖会技术沙龙聚焦具身数据,探讨预训练数据选择、多模态采集与规模化降本。
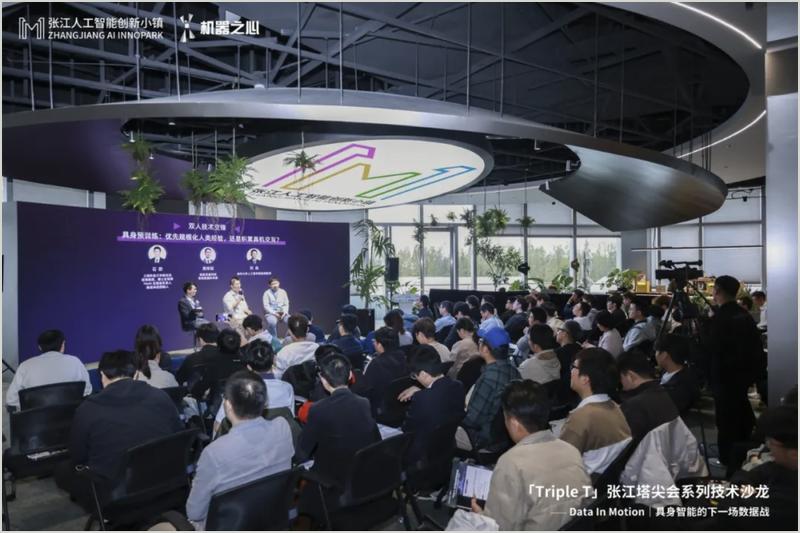
11 月 5 日,由张江 AI 创新小镇生态公司与机器之心联合主办的「Triple T」张江塔尖会系列技术沙龙举行,主题为「Data In Motion|具身智能的下一场数据战」。活动通过双人技术交锋、三场 Open Mic 与一场产业 Panel,围绕预训练数据选择、多模态采集、数据配方与评测、规模化交付等方向,探讨具身数据转化为机器人能力的路径与瓶颈。
- 黄用韬认为现阶段应优先积累真机数据,触觉应尽早融入基础能力学习,而非仅作后训练补充。
- 刘淼强调数据选择取决于应用定位与训练阶段,人类数据在主动感知、任务规划等方面有潜在价值。
- 马道林分享多模态采集与物理交互数据,展示融合视觉、触觉、语言、动作的 VTLA 模型在真机任务中的表现。
- 李永露提出数据配方应结合模型结构、训练目标与评测方式,硬件、模型与数据基础设施需协同迭代。
- 产业 Panel 围绕数据多样性、触觉模态利用与规模化降本展开,嘉宾期待行业形成统一数据标准。
为什么值得看
具身智能数据战的核心分歧与落地路径一次看清。
适合谁关注
具身智能研究者、机器人从业者与数据工程师。