NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链
2026.10.28 · 收录日 2026.10.28 · 事件 · 论文 · 媒体报道
南洋理工等团队提出 NV-CoT,用连续数值坐标替代文本 token 做区域选择,定位 IoU 提升 12.2 个百分…
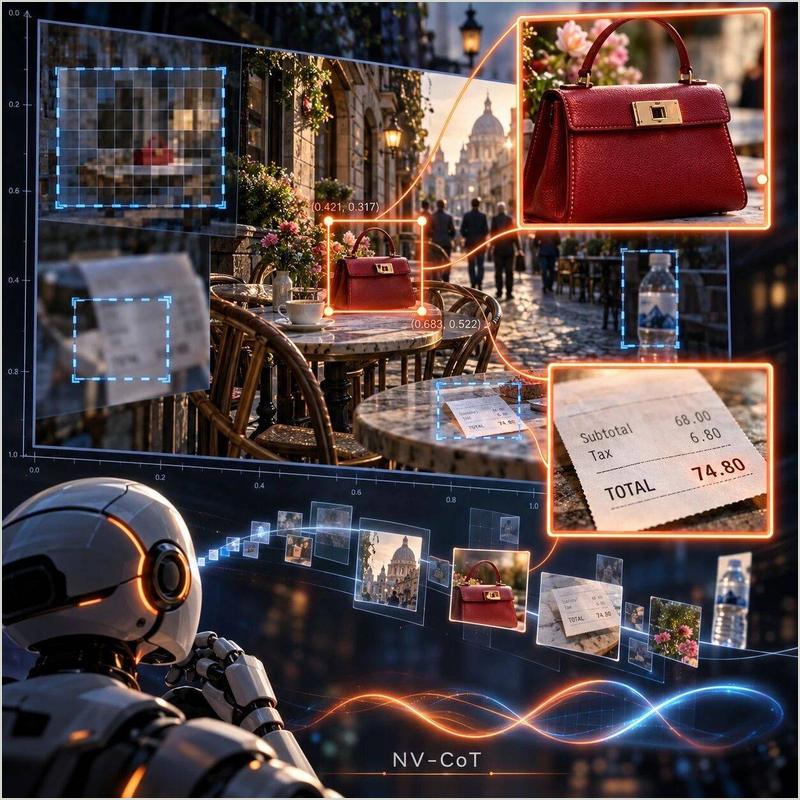
南洋理工大学、中国科学技术大学、新加坡国立大学与微软研究院提出 NV-CoT,让多模态大模型直接预测连续数值坐标来选择图像区域,而非把边界框写成文本 token。该方法在 SFT 与强化学习两条路线均获提升,定位 IoU 从 47.3 提升至 59.5,已获 NeurIPS 2026 Oral。
- NV-CoT 在语言模型输出头外增加四个轻量线性输出,直接预测边界框左上角与右下角坐标,文本仍由原词表生成。
- SFT 中文本用交叉熵、坐标用回归损失,Vis-CoT-363K 验证集定位 IoU 从 47.3 提升至 59.5,提高 12.2 个百分点。
- 强化学习阶段采用 Laplace policy 将边界框建模为四维连续分布,并增加第五个输出预测共享尺度控制探索范围。
- SFT 相对 Vis-CoT 在 V* Bench、HR-Bench 4K、HR-Bench 8K 三个 Overall 分别提高 3.7、2.0 和 1.6 个百分点。
- RL 单次放大版本相对 DeepEyes 分别提高 2.6、1.3 和 1.6 个百分点,收益还延伸到 MMMU-Pro、ChartQA 与 OCRBenchv2。
为什么值得看
视觉思维链的坐标建模方式被重新设计,SFT 与 RL 通用。
适合谁关注
多模态大模型研究者、视觉推理与强化学习方向工程师。