OpenAI 为 GPT-5.6 加装激活分类器,用模型内部神经模式拦截违规输出
2026.11.02 · 收录日 2026.11.02 · 事件 · 行业动态 · 官方发布
OpenAI 用模型自身激活值训练轻量探针,实时拦截违规回复
OpenAI 采用“纵深防御”思路,在文本分类器之外新增激活分类器(探针),直接读取模型内部激活值判断回复是否违规。自 GPT-5.6 起,该探针已覆盖所有助手回复,并部署到内部与外部流量。相比文本分类器,探针可流式中途拦截、更抗越狱且运行更高效。
- 探针是轻量 ML 模型,输入模型中层残差流激活,输出二分类 logits
- 自 GPT-5.6 起,激活分类器运行在所有助手回复上,已部署于内外部流量
- 优势:可流式中途拦截违规回合、比大文本分类器更抗越狱、运行更高效
- 局限:依赖标注数据,只能检测已知不良行为;换基座模型需重新训练
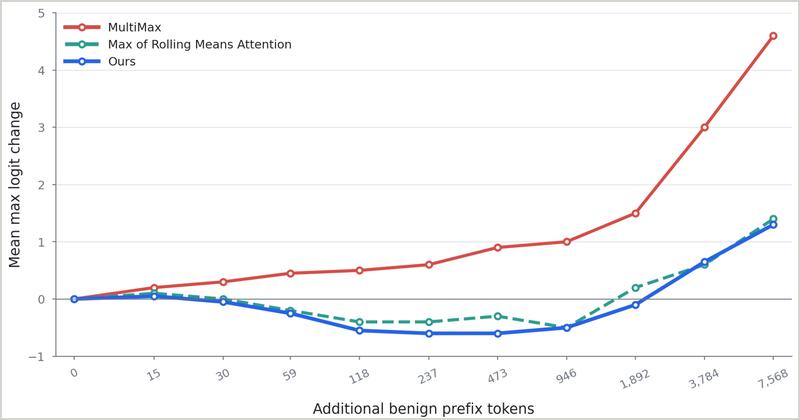
- 架构基于 Attention probes,用 MLP+QV-attention 与指数移动平均,内存降至 O(num_heads)
为什么值得看
了解前沿模型安全防线的技术路线与能力边界
适合谁关注
AI 安全研究者、模型对齐工程师、AI 产品风控从业者