决策模型何时需要思考?StartLux-Decision的按需推理与概率校准
2026.11.04 · 收录日 2026.11.04 · 产品 · 新模型 · 论文预印本
研究提出StartLux-Decision,用按需推理与概率校准让决策模型先预测、再决定是否推理。
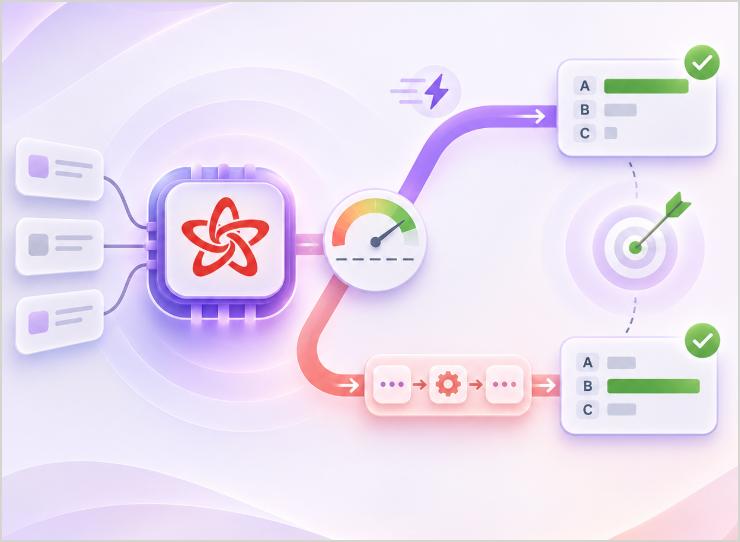
来自StartLux、香港大学与南方科技大学的研究者提出StartLux-Decision,将单次预测版Instant与按需推理版AutoThink建立在统一的选项概率接口上,通过三阶段训练发展决策能力,并提出RLCD²以推理前后概率预测质量的变化训练推理策略。配套评测DecisionPivot检验关键细节变化时模型能否相应改变决策。
- AutoThink先做一次因果前向得到初始选项分布p₀,最大选项概率达0.9时直接返回,低于0.9才生成推理轨迹并读取p₁。
- 最终输出对两次分布加权,75%的推理后权重依据预留样本上的Brier分数选择,关注整个概率分布的预测质量。
- RLCD²用冻结评分模型读取推理前后选项概率,奖励由概率评分增量与超长惩罚组成,软长度预算为3,072个token。
- 在2,986条预留样本上,9B模型推理自行结束比例由45.9%升至93.9%,平均长度从2,494降至868个token。
- DecisionPivot含13类程序生成任务共7,800道题,4B、9B、27B AutoThink成对准确率分别为59.9%、59.9%和86.9%。
为什么值得看
揭示决策模型按需推理与概率校准的训练取舍。
适合谁关注
关注大模型推理与决策的研究者和开发者。