让Code Agent从自己的错误中进化:ReTerm探索失败驱动的RSI
2026.11.04 · 收录日 2026.11.04 · 事件 · 论文 · 论文预印本
复旦、港中文MMLab与上交提出ReTerm,让终端智能体从自身失败中学习恢复。
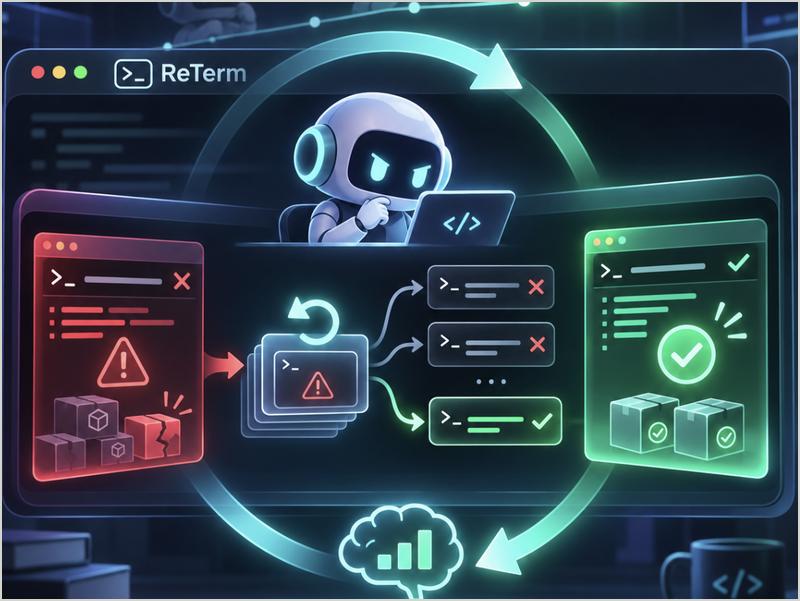
复旦大学、香港中文大学MMLab和上海交通大学研究者提出ReTerm,让终端智能体尝试恢复自己造成的失败,并从恢复结果中学习,探索失败驱动的递归自我改进(RSI)路径。团队构建ReTerm-10K恢复示范数据用于冷启动,再用ReTerm-GRPO让Agent从自身失败现场出发自主恢复并更新参数。
- ReTerm把「自己遇到问题、自己尝试恢复、根据成败更新参数」接入同一个训练闭环,模型变化后新失败继续成为下一轮学习起点。
- 团队构建ReTerm-10K:先收集基础模型自己失败的任务,再请更强教师模型示范恢复,经筛选得到约一万条恢复轨迹用于冷启动训练。
- ReTerm-GRPO保留失败时的环境和操作记录,让Agent从同一失败现场独立尝试多种恢复办法,由任务验证器判断成败并转化为强化学习信号。
- ReTerm-9B在Terminal-Bench 2.0从20.2%提升至34.8%、SWE-bench Verified从45.2%提升至58.4%、OpenThoughts-TBLite从…
- 消融实验显示,恢复示范SFT将Terminal-Bench 2.0从20.2%提升至25.8%,标准GRPO达28.0%,ReTerm-GRPO达34.8%,专门优化恢复行为额外带来6.8个百分点增…
为什么值得看
失败驱动的自我改进闭环,为终端Agent能力提升提供可实验路径。
适合谁关注
关注AI Agent、代码智能体与强化学习的研究者和开发者。