当机器人走出预设任务:RobotAgentBench全面评测机器人的开放世界能力
2026.10.29 · 收录日 2026.10.29 · 产品 · 论文 · 论文预印本
Aether AI 与 UC San Diego 提出 RAB 基准,用 50 种家庭布局评测机器人开放世界自主能力。
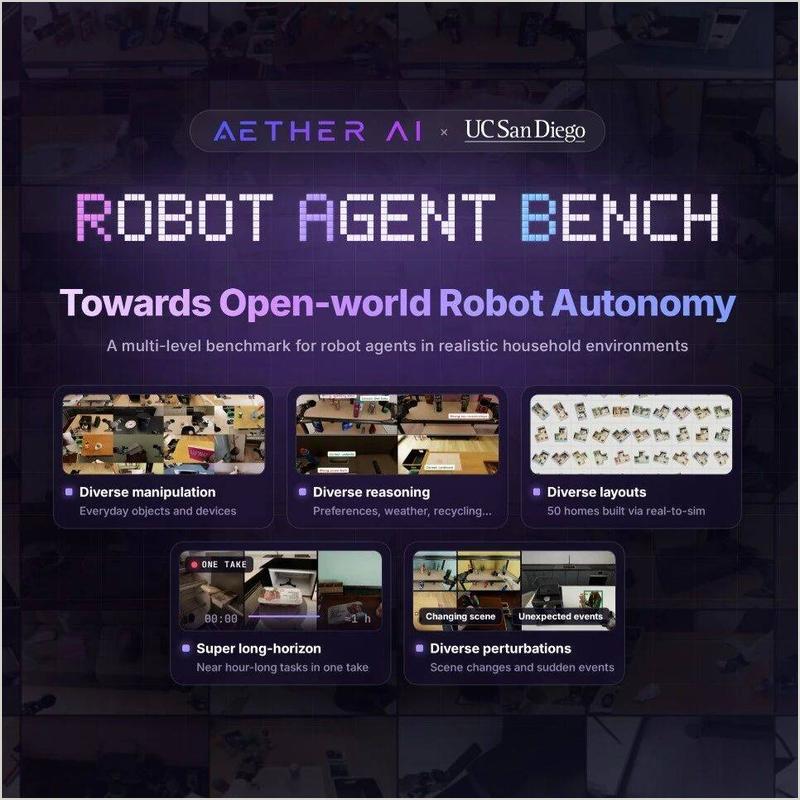
Aether AI 和 UC San Diego 团队提出 RobotAgentBench(RAB),以真实家庭为起点构建 50 种家庭布局、90 项原子任务、18 项短程任务、8 项长程任务和 4 类开放式场景,系统比较独立 VLA/WAM 策略与多种机器人智能体架构。结果显示独立策略在任务发现上得分均低于 2,而引入规划—执行—验证框架后表现显著提升,Codex 与 InternVLA-A1.5 的混合配置任务级平均分达 48.5,为所评测配置中最高。
- RAB 将机器人自主能力拆为操作、任务发现、情境推理、失败恢复、鲁棒性五个维度,覆盖任务级与场景级评测。
- 独立 VLA/WAM 策略任务发现得分均低于 2,开放场景综合得分最高仅 2.0,InternVLA-A1.5 与 OpenWAM-Alpha 停滞时间占比分别达 88.3% 和 84.6%。
- 引入编码智能体后明显改善:Antigravity CLI 全代码配置任务级平均分 39.7,情境推理 80.0;Codex 与 InternVLA-A1.5 混合配置达 48.5,开放场景综合得分…
- 递归自我改进(RSI)十轮实验中,Codex 任务级平均分从 31.0 升至 42.3,停滞时间占比从 33.7% 降至 12.3%,失败恢复从 15.4 升至 38.9。
- 真实家庭与仿真匹配子集上得分普遍下降,Codex 任务级平均分从 34.2 降至 31.9,开放场景综合得分从 8.7 降至 6.0,但相对排名大致保持。
为什么值得看
首次系统量化机器人从执行指令到自主完成需求的差距。
适合谁关注
机器人研究者、具身智能与 VLA 方向从业者。