180B参数塞进32GB内存:用Transformers把MoE推理推到极限
2026.11.18 · 收录日 2026.11.19 · 观点 · 技术实测 · 社区热议
作者实测在32GB Mac上用Transformers流式加载MoE专家,对比Strata、llama.cpp与…
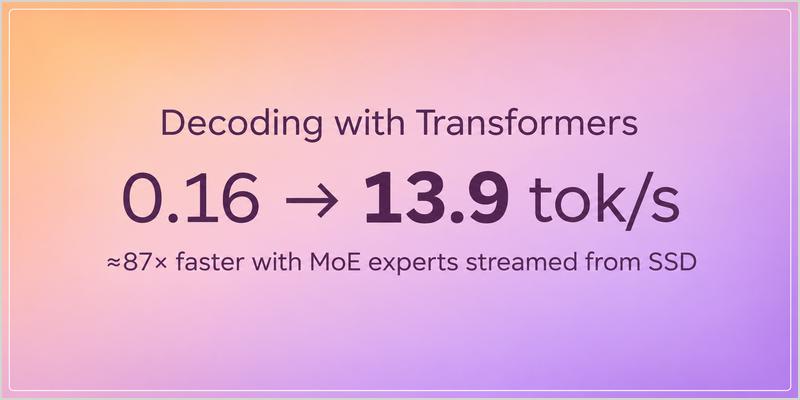
作者 Tarek Ziadé 想在 32GB 内存的 MacBook 上本地跑 180B 级 MoE 模型,先对比了 llama.cpp、vLLM 和 Transformers 的专家卸载方式,并在单张 A10G 上实测 Qwen3.6-35B-A3B:Strata 达 82-88 tok/s,llama.cpp 63-64 tok/s,vLLM 仅 20.1 tok/s,Transformers + Accelerate 只有 0.16 tok/s。他因此尝试直接修复 Transformers 的卸载路径。
- Strata 只把热专家留在 VRAM,其余放 RAM 甚至磁盘,专家占 MoE 权重 90% 以上
- llama.cpp 用 mmap 把专家留在 CPU 计算,专家放得进 RAM 时很难被击败,放不下则页缓存抖动
- vLLM 的 --cpu-offload-gb 不缓存专家,每个 token 都要重新过 PCIe,且默认连稠密层一起卸载
- Transformers 经 Accelerate 按模块卸载,MoE 层会整组专家搬上 GPU,无缓存也不感知路由
- A10G 实测:Strata 82-88 tok/s,llama.cpp 63-64 tok/s,vLLM 最好 20.1 tok/s,Transformers 0.16 tok/s
为什么值得看
看清 MoE 本地推理的卸载瓶颈与各家引擎差距。
适合谁关注
想在消费级设备本地跑大 MoE 模型的开发者。