大模型为何长出「巨大激活」?清华、北大研究从反向传播找到新线索
2026.11.21 · 收录日 2026.11.21 · 模型 · 论文 · 论文预印本
清华北大团队发现注意力汇聚会形成梯度汇聚,巨大激活通过RMSNorm调节局部梯度
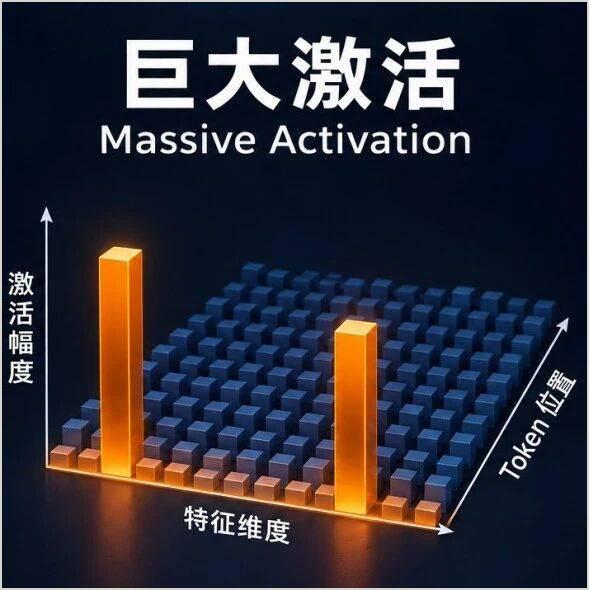
清华大学、北京大学研究团队在NeurIPS 2026接收论文中,从反向传播视角研究大模型中的注意力汇聚与巨大激活现象。他们发现注意力汇聚会把训练信号集中到少数Token上形成梯度汇聚,而巨大激活可通过RMSNorm衰减这些局部集中的梯度,起到梯度调节作用。
- 注意力汇聚指序列开头少数Token吸引大量注意力,即使语义不多,模型仍频繁关注它们
- 研究团队在从头训练模型和多款开源模型上测量,发现RMSNorm后注意力输入处梯度集中普遍存在,首Token梯度范数通常高出其他早期位置平均值一到两个数量级
- 拆分Query、Key、Value路径后,Key和Value路径在首Token处出现突出峰值,Value路径最显著,Query路径相对平缓
- RMSNorm的雅可比矩阵算子范数上界与输入均方根尺度成反比,激活尺度越大对反向梯度收缩能力越强
- 研究提出V-scale方法,在0.3B模型中梯度汇聚比值中位数从约40.3降至5.6,首Token残差流激活范数显著下降
为什么值得看
揭示大模型异常激活的训练机制,为理解模型内部行为提供新视角
适合谁关注
大模型研究者、训练工程师、AI机制可解释性关注者