同一模型换套壳:CUGA、Hermes、Deep Agents 在 AppWorld 上从 30% 到 81%
2026.11.03 · 收录日 2026.11.04 · 观点 · 行业动态 · 官方发布
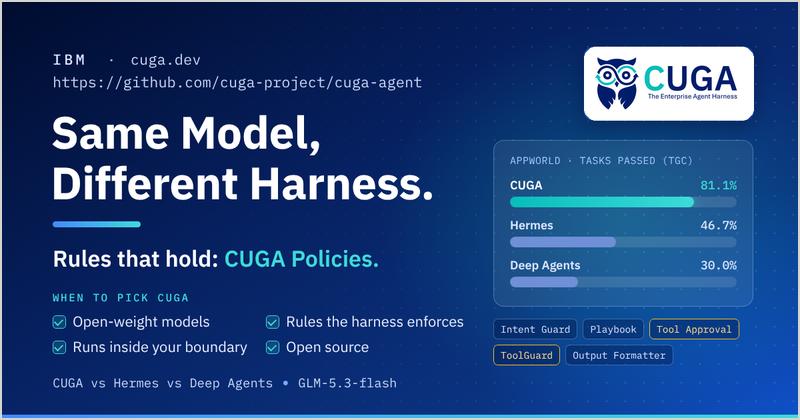
同一开源模型只换 Agent 框架,AppWorld 任务通过率从 30% 升到 81%。
IBM 团队用同一个开源模型 GLM-5.3-flash 在 AppWorld 的 90 个任务上对比 CUGA、Hermes 和 Deep Agents 三种 Agent 框架,只换框架不改模型。CUGA 任务通过率 81.1%(73/90),Hermes 为 46.7%,Deep Agents 为 30.0%;场景全通过率 CUGA 为 66.7%,另两者分别为 26.7% 和 6.7%。作者强调这不是对 Hermes 或 Deep Agents 的否定,而是框架要匹配任务。
- 同一模型 GLM-5.3-flash、同一 90 个 AppWorld 任务,仅更换 Agent 框架,任务通过率从 30% 变到 81%。
- CUGA 任务通过率 81.1%(73/90),Hermes 46.7%(42/90),Deep Agents 30.0%(27/90)。
- 场景全通过率(SGC)差距更大:CUGA 20/30,Hermes 8/30,Deep Agents 2/30,SGC 奖励一致性而非侥幸。
- CUGA 在 AppWorld 中启用了任务分解、聚焦工具、工具检索、执行前验证与自动反思等能力。
- 作者列出三项局限:90 个任务样本单一、各框架配置不完全相同、未启用策略因而未测策略执行。
为什么值得看
用受控实验说明 Agent 框架本身对结果影响巨大。
适合谁关注
做企业级 Agent 选型与评测的开发者、架构师。