用基准测试量化 JavaScript 框架的 AI 开发成本
2026.11.01 · 收录日 2026.11.01 · 观点 · 行业动态 · 本人发布
作者用 PokéAPI 应用实测各 JS 框架在 AI 代理下的开发成本与质量
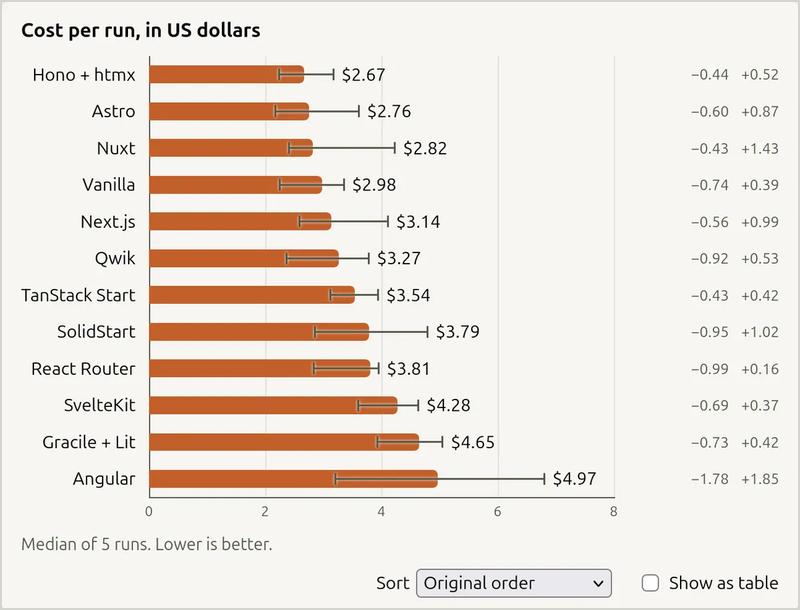
作者针对「某框架更适合 AI 代理」这类无证据说法,用 PokéAPI 设计了一个小型 Pokémon 应用基准,让代理分别用 Next.js、Nuxt、SvelteKit 等框架构建,再按一致性测试、开发时间、token 消耗、代码行数和 Lighthouse 性能与无障碍评分对比。每个框架取 5 次运行的中位数,Angular 因两次失败只跑了 3 次。作者强调结果具有随机性,并非完美实验。
- 作者批评 Web 开发社区决策常靠「感觉」,框架「极快」「更适合代理」等说法往往没有证据
- 基准做法:用 PokéAPI 构建小型 Pokémon 应用,让代理用指定框架生成,再用一致性测试套件防止作弊
- 评测维度包括开发时间、token 消耗、代码行数,以及 Lighthouse 性能与无障碍评分
- 每个框架取 5 次运行中位数,Angular 因两次未能生成可用应用只取 3 次
- 作者承认实验有局限:应用偏内容型、交互少,且 LLM 与 Lighthouse 结果都存在随机性
为什么值得看
用实测数据替代「框架更适合 AI」的直觉判断
适合谁关注
关注前端框架、AI 编程代理与工程效率的开发者