VLA/WAM已死,基模当立?Mind2Act World通用基准用「知行合一」角度为具身模型诊断进化方向
2026.11.22 · 收录日 2026.11.22 · 模型 · 论文 · 论文预印本
清华等16家机构发布通用机器人操作诊断基准,首批评测9个系统、56,700个仿真回合。
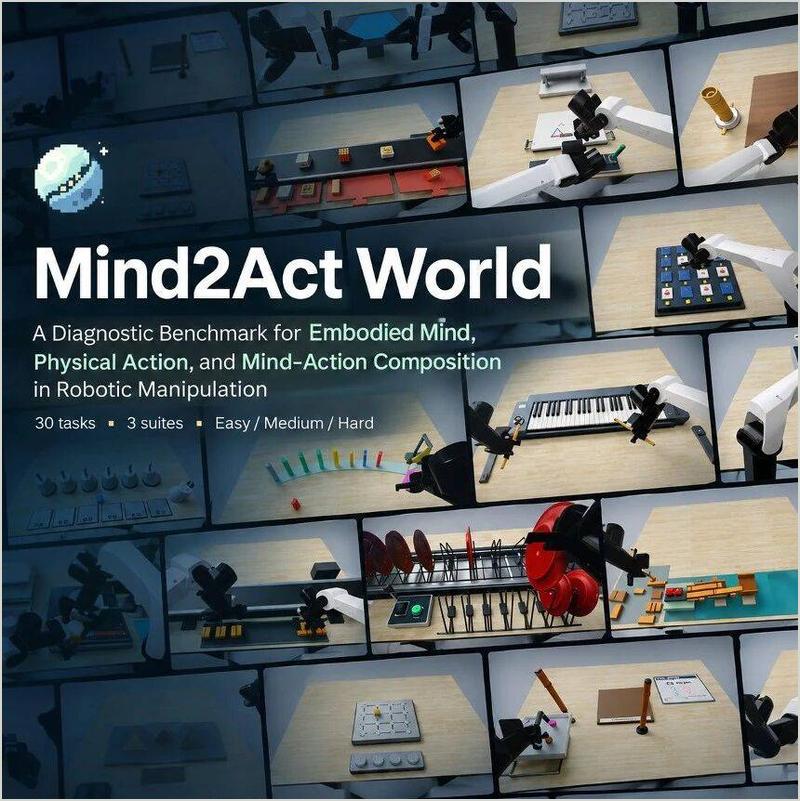
清华大学 mmlab@SIGS 联合远行光年等 16 家机构发布 Mind2Act World 诊断基准,含 30 项任务、180 种配置,把「想」与「做」分开考再合起来考。首批评测覆盖 9 个系统、56,700 个仿真回合:最好的 Agent 在 Mind 任务成功率 52.7%、Act 39.0%,Mind2Act 仅 12.0%;端到端策略 Mind2Act 最高 3.6%。
- Mind2Act World 由清华 mmlab@SIGS 联合远行光年等 16 家机构发布,共 30 项任务、180 种配置,分 Mind、Act、Mind2Act 三组各 10 项。
- 评测器为每个失败回合追究第一个无法挽回的错误,区分错在「想」「做」还是「协同」,汇总成模型诊断卡。
- Agent 榜 GPT-6 Astra 居首:Mind 52.7%、Act 39.0%、Mind2Act 12.0%;端到端榜 InternW0 以 8.68 综合得分居首。
- 多数失败回合在很早阶段就中断,首先出在「协同」环节的只占 6%–11%,物理执行是占比最大的一类失败。
- 诊断卡给出改进方向:端到端策略按断点补演示并加入出错后补救示范,Agent 返回每步执行结果、先检查再继续、停止前先重试。
为什么值得看
看清具身模型到底差在哪一步,而非只看成功率排名。
适合谁关注
具身智能研究者、机器人算法与数据工程师。