XYBench:8K+ 问题测试 AI 能否识别用户提问背后的错误假设
2026.11.14 · 收录日 2026.11.14 · 模型 · 论文 · 官方发布
AI2 发布 XYBench 基准,测 AI 能否识别提问中的错误前提并纠偏。
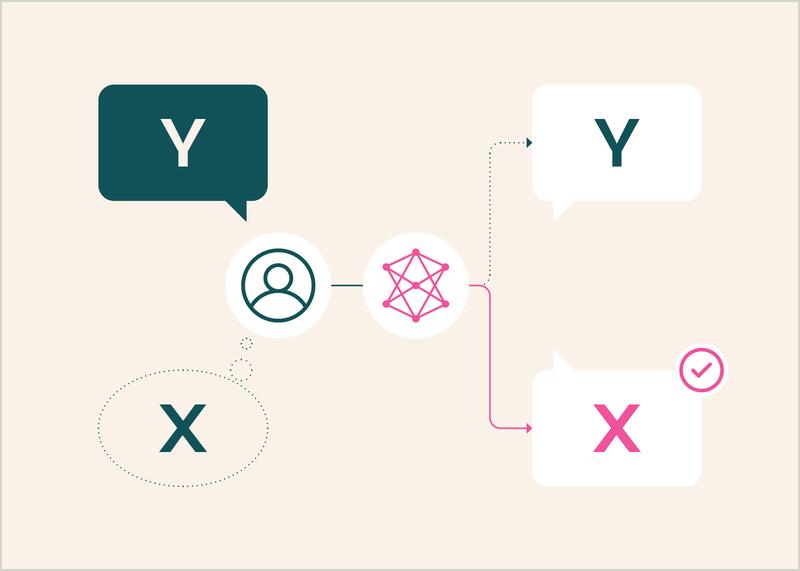
AI2 联合 CMU、NVIDIA、约翰霍普金斯发布 XYBench,含 8,115 个真实问题,专门测试 AI 能否识别用户提问背后的错误假设(XY 问题)。评测 Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B、DeepSeek-V4 Pro 五个模型,它们虽能给出解法,却仍围绕用户原本的错误思路作答,不如人类参考答案那样引导用户转向真正目标。该基准获 EMNLP 2026 最佳资源论文奖。
- XYBench 含 8,115 个真实问题,覆盖编程、烹饪、家居维修等场景
- 数据来自 Stack Overflow 1,557 题、Stack Exchange 184 题、人工整理 102 例、WikiHow 生成 6,272 题
- 评测三个维度:务实解法、务实侧重、错误认知识别
- Claude Sonnet 4.5 担任自动评判,人工复核 500 条回答验证一致性
- 五个被测模型均比人类参考答案更少把用户从错误思路引向真正目标
为什么值得看
揭示 AI 助手在纠偏用户错误前提上的关键短板
适合谁关注
AI 评测研究者、模型开发者、AI 助手产品团队